
怎么省 token?2026 AI 编程省钱指南:Claude Code / Codex 实测 10 个技巧
怎么省 token?核心答案:管好上下文、少踩缓存失效、选对计费方式。Claude Code 官方数据显示,企业用户平均每人每个活跃日花费约 13 美元,其中大量消耗浪费在重复发送的上下文和缓存失效上。本文基于 Anthropic 和 OpenAI 官方文档,整理 10 个当天就能落地的省 token 技巧,附可直接执行的检查命令。
目录
- Agent 的 token 都花在哪了?
- 第一层:管好上下文(4 个技巧)
- 第二层:别踩缓存失效的坑(附操作对照表)
- 第三层:模型选择与思考预算
- 计费与额度:订阅、API、credits 怎么选
- Claude Code vs Codex 省 token 对照表
- 常见问题 FAQ
最后更新:2026 年 9 月 1 日|文:AI345 编辑部
Agent 的 token 都花在哪了?
很多人以为"我问一句、它答一句",token 应该很省。实际不是。
Claude Code 这类 Agent 工具的工作方式是:每发一条消息,都会把系统提示词、项目说明、之前所有的对话和工具输出完整地重新发送一遍。你聊到第 30 轮时,模型看到的是前 29 轮的全部历史加上你的新问题。这就是为什么会话越长、额度掉得越快。
好消息是,官方有"提示词缓存"(prompt caching)机制:没变过的部分按"缓存读取"的折扣价计费,只对新增内容全价收费。所以省 token 的全部思路,其实就围绕两件事展开——让上下文别无限膨胀,以及别做让缓存失效的操作。
一个判断你有没有踩坑的直观方法:在 Claude Code 里输入 /usage,会看到一行 Prompt cache 统计,官方示例里健康会话的缓存命中率在 90% 上下。如果你的命中率很低,说明下面的坑你踩了不少。
第一层:管好上下文,别让会话无限膨胀
技巧 1:换新任务,先 /clear
/clear 会开启全新会话,历史上下文全部清零。上一个任务收尾后、开始下一个不相关任务前,先 clear。这是最简单也最容易被忽略的一条——很多人一个终端窗口用一整天,历史里堆了上午调 bug 的几百行日志,下午写新功能时每轮都在为它们付费。
技巧 2:/compact 放在任务间隙做,不要任务做到一半做
/compact 会把对话压缩成摘要来释放上下文空间,但它有一个隐藏成本:压缩本身会让缓存整体重建,下一次请求变慢且变贵。官方文档明确把"压缩对话"列在缓存失效操作清单里。正确做法是在一个大任务自然收尾、准备开下一件事之前再 compact,别在任务正嗨时中途执行。
技巧 3:精简 MCP,不用的 server 及时断开
每个 MCP server 的工具定义都会进入系统提示词,而系统提示词位于上下文最前面——动它一次,后面所有内容全部重新计费。装了一堆用不上的 MCP(浏览器、数据库、设计工具全挂着),等于每一轮都在为用不到的工具定义付费。官方"降低 token 消耗"清单里专门有一条"减少 MCP server 开销"。只保留当前任务真正用到的,切换任务时断开重连(注意断开本身也会触发一次缓存重建,所以最好和 /clear 一起做)。
如果你还分不清 MCP 和 Skill 的分工,可以读这篇:MCP 和 Skill 的区别:AI Agent 工作流该先用哪个。
技巧 4:把 CLAUDE.md 里的长说明移到 Skill
CLAUDE.md(项目说明文件)属于"项目上下文"层,每次会话都会加载。官方建议把不常用的大段说明从 CLAUDE.md 移到 Skill 里,按需加载——Skill 只在被调用时才进入上下文。同一个项目文档越厚,这一条省得越多。
Claude Code 和 Codex 安装 Skill 的步骤分别见:Claude Code 怎么安装 Skill、Codex Skill 怎么安装。
第二层:别踩缓存失效的坑(重点,附对照表)
这是全文最值钱的一节。Claude Code 的缓存按“前缀精确匹配”工作,上下文最前面任何一处变动,后面所有内容都要重新全价处理一遍。
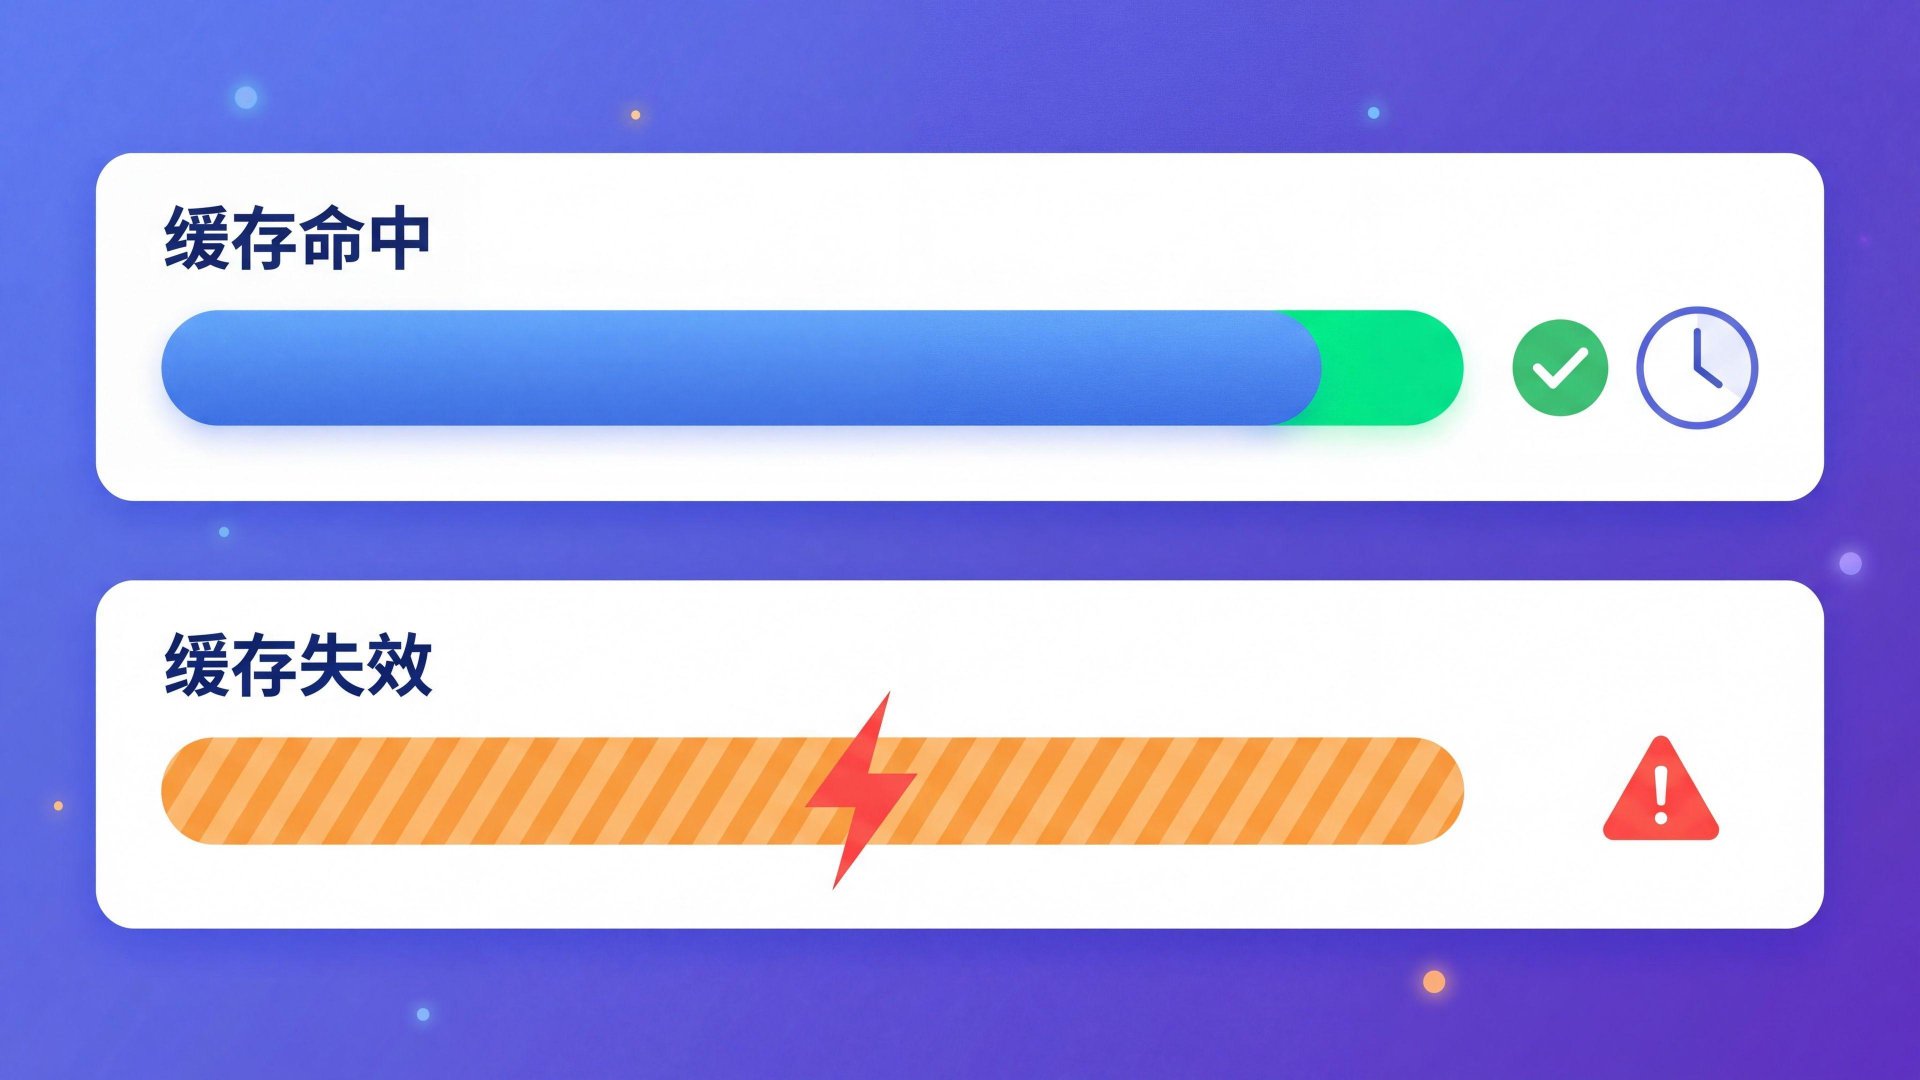
官方文档列出的缓存失效操作包括:
| 操作 | 后果 | 建议 |
|---|---|---|
| 中途切换模型(/model) | 缓存全部失效,历史全量重算 | 会话开始时定好模型,任务间隙再切 |
| 中途调整 effort(思考档位) | 同上,effort 是缓存键的一部分 | 开局定档,别边跑边调 |
| 开启 fast mode | 触发缓存重建 | 需要时再开,开了就别反复切换 |
| 连接/断开 MCP server | 系统提示词变化,全部重算 | 和 /clear 一起做 |
| 启用/停用插件 | 工具定义变化,全部重算 | 任务间隙再动 |
| 否决整个工具 | 工具定义被移除,触发重建 | 用权限模式代替直接否决 |
/compact 压缩对话 |
对话层重写,缓存重建 | 放在任务间隙 |
| 升级 Claude Code 版本 | 版本变化触发重建 | 别在长任务中途升级 |
反过来,这些日常操作不会清缓存,放心用:编辑仓库里的代码文件、会话中途修改 CLAUDE.md、切换权限模式、调用 Skill、rewind 回退对话。
另外注意缓存有效期约 1 小时(TTL)。如果你去吃个午饭回来,缓存大概率已经冷了,第一轮请求会重新全量计费——这是正常现象,不用慌。
一个实测验证方法:/usage 输出里的 Prompt cache 行会显示命中率和 miss 次数,官方示例格式是"14 次请求 · 91% 的输入 token 来自缓存 · 2 次 miss"。改完工作习惯后观察一两天这个数字的变化,比任何教程都直观。
第三层:模型选择与思考预算
技巧 5:按任务复杂度分层用模型
官方对 Codex 的建议是同样的思路:复杂任务用强模型(如 GPT-5.6 系),日常开发用性价比模型。翻译成习惯:日常小改动、问答、解释代码用轻量档;架构设计、跨文件重构、疑难 bug 才上重模型。很多人全程开着最强档,是最常见的浪费。
技巧 6:调低 extended thinking(思考预算)
官方"降低 token 消耗"清单里有一条"调整 extended thinking"。思考越深、消耗越大,简单任务给低档思考预算即可。
技巧 7:让 subagent 干"输出很长"的活
读一堆日志、扫描大量文件、跑长测试输出——这类"过程很长但结论一句话"的活,交给子代理(subagent)去做,主会话只接收结论,避免把几十 KB 的过程输出灌进主上下文。
技巧 8:重复流程交给 hooks 和 Skill
固定要跑的格式化、检查、生成步骤,写成 hooks 或 Skill 让程序自动执行,而不是每次用对话让模型来驱动——机械性工作不需要模型参与。
计费与额度:订阅、API、credits 怎么选
先给结论:重度且稳定使用的开发者,包月订阅几乎总是更划算;偶尔用一次的,按量付费或免费额度更合适。
- Claude Code:按 API token 消耗计费;Pro/Max 等订阅套餐包含固定用量,官方企业数据是平均每个开发者每个活跃日约 13 美元、每月 150–250 美元,90% 的用户每天低于 30 美元。订阅用户在
/usage里看的是套餐用量条,不是美元账单。 - Codex:包含在 ChatGPT 各档套餐里(含免费档),额度随套餐不同;Codex、ChatGPT Work 等功能共享同一个额度池,用量取决于模型、任务复杂度、上下文长度、推理强度和工具调用。CLI 里输
/status看当前额度,网页端在 chatgpt.com/codex/settings/usage 看明细。 - 用超了怎么办:Codex 的 Plus/Pro 用户可以不换套餐直接购买 credits 补充;Claude 订阅也有 usage credits 机制。
一个省钱的隐性技巧:长任务消耗远大于短请求(官方原文明确提示"一个长跑任务可能消耗远多于一个短请求")。跑自动化、批量任务前,先用小任务试跑一遍流程确认无误,再放大执行。
Claude Code vs Codex:省 token 手段对照表
| 省钱手段 | Claude Code | Codex |
|---|---|---|
| 查看用量 | /usage(含缓存命中率) |
CLI /status / 网页 usage 面板 |
| 清理上下文 | /clear、/compact(任务间隙用) |
新开会话/新任务 |
| 模型分层 | 会话开头定好,任务间隙再切 | 日常用轻量模型,复杂任务上重模型 |
| 减少系统提示词 | 精简 MCP、CLAUDE.md 说明移到 Skill | 精简插件与接入的工具 |
| 缓存优化 | 避免中途切模型/动配置,关注命中率 | 官方提示控制上下文与推理强度 |
| 超额补救 | usage credits | Plus/Pro 可购买 credits |
两个工具怎么选,延伸阅读:Cursor vs Claude Code:2026 年 AI 编程工具怎么选。
总结
省 token 不靠玄学,就三句话:新任务开新会话,任务中间别动配置,重活才上重模型。把 /usage 的缓存命中率当成你工作习惯的体检指标,改一条习惯看一次数字,一周内就能看到明显变化。
参考来源(均为官方一手文档):
- Claude Code 官方文档:Manage costs effectively
- Claude Code 官方文档:How Claude Code uses prompt caching
- OpenAI 帮助中心:Using Codex with your ChatGPT plan
常见问题
1 个 token 大概等于多少字?
中文大约 1 个字对应 1–2 个 token(视具体模型的分词器而定),英文大约 0.75 个单词对应 1 个 token。Agent 的消耗大头不是你的提问,而是反复发送的历史上下文和工具输出。
为什么我的额度用得特别快?
按概率从高到低排查:① 一个会话用一整天没 clear;② 频繁中途切模型、调档位、动 MCP,导致缓存反复失效;③ MCP 和插件挂了一大堆;④ 让模型直接读大日志、大文件,过程输出全部进了上下文。
`/compact` 会不会反而更费 token?
会有一次性成本:压缩后缓存重建,下一次请求变慢变贵。但它换来的是后续每一轮的上下文变短,长会话里总体是赚的。关键是别频繁 compact,放在任务间隙做。
订阅和 API 按量付费,哪个省钱?
轻度用户按量或免费额度更合适;每天都要重度使用的开发者,订阅几乎总是更划算。以 Claude Code 官方企业数据为例,重度开发者按 API 计费平均每月 150–250 美元,已超过多数订阅套餐的价格。
Codex 额度用完了怎么办?
在 CLI 输 `/status` 或打开 usage 面板确认是哪个额度用尽、什么时候重置。等重置、升级套餐,或者(Plus/Pro)直接购买 credits 都是官方支持的选项。
省 token 会影响产出质量吗?
用好缓存和上下文管理不会——它们省的是"重复内容"的钱,模型看到的信息没变。真正会伤质量的是过度砍上下文:该给的项目说明、关键文件还是要给,省的应该是历史垃圾和重复传输。
 京ICP备2024094994号-29