
Codex 上下文压缩慢?500k 新默认与 3 种解法
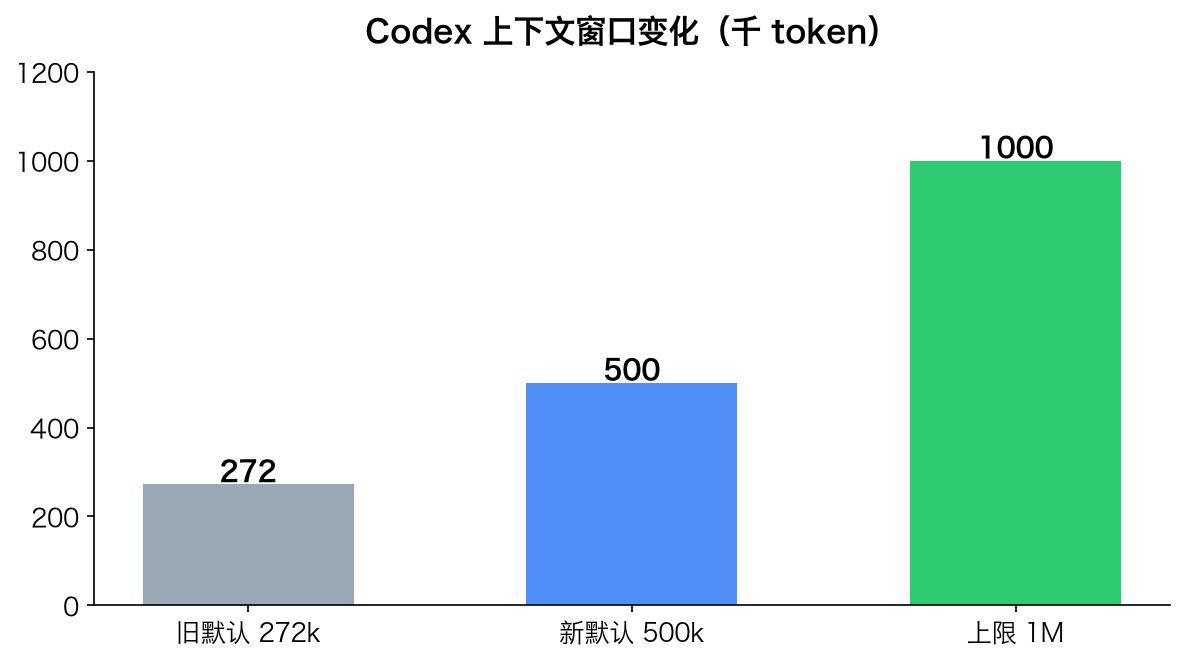
Codex 上下文压缩慢,是对话接近窗口上限时模型自动整理历史导致的。2026 年 10 月 12 日 OpenAI 已把 Codex 与 Work 环境下 GPT-6.1 Sol 的默认上下文从 272k 提到 500k(增幅约 80%),上限 1M,压缩触发频率明显下降;还觉得慢,就手动把窗口开到 1M,或者养成拆小任务的习惯。注意:免附加费不等于额度更省,缓存反复读取仍计入用量。
10 月 12 日发生了什么
OpenAI 工程师 Thibault Sottiaux(Tibo)10 月 12 日宣布,Codex 与 Work 环境的默认上下文从 272k 提升到 500k,手动可调到 1M 上限,且用订阅额度跑 GPT-6.1 Sol 不再收长上下文附加费(来源:站长之家当日报道、新智元报道,Tibo 原帖见文末)。
信息发布时间是 2026 年 10 月 12 日,行动指引:桌面端与网页端升级后新会话即用新默认值,不用改任何配置。
现象确认:你是不是也卡在这两步
- 长任务跑了一半,界面转圈,一等就是几十秒到两分钟(开发者 Lasse 实测吐槽,压缩一次最长等两分钟)
- 压缩完还得检查有没有漏掉最初要求,比如开工时说过「接口要兼容旧版」,改完十几个文件发现旧接口坏了,回头补锅
对号入座:频繁跨多文件改代码、单次输入很大的用户都会遇到。Codex 用法不熟可以先看站内 Codex 做视频的实战指南 熟悉工作流。
为什么 Codex 会触发上下文压缩
让 Codex 查文件、改代码、跑测试,读到的代码和报错都会占用上下文。快装满时,它必须先把前面的对话和工作进度压缩整理一遍,腾出空间才能继续干。所以压缩慢的本质是「上下文被占满加压缩过程串行等待」,不是网速或机器问题。Tibo 在公告里也确认,扩容能减少压缩,让模型在长任务里保留更多细节。
解法一:升级默认 500k(已自动生效)
10 月 12 日起新会话默认 500k,多数任务不会再频繁触发压缩。确认方法:新开会话跑一次长任务,用 /status 查看上下文占用和剩余空间。GPT-6.1 Sol 是 9 月底发布的 GPT-6 系列升级模型,完整脉络见站内 GPT-6 发布与上手教程。
来源:Tibo 公告,OpenAI 官方 X 帖子。
解法二:手动调高到 1M(三行配置)
在 ~/.codex/config.toml 文件最顶部写入三行,注意必须放在所有 [section] 标题之前:
model = "gpt-6.1-sol"
model_context_window = 1000000
model_auto_compact_token_limit = 900000
保存后重启桌面端,新对话即生效;验证用 /status 查看上下文占用,界面显示会乘 95% 系数属正常现象。只试一次的话,用临时 CLI 参数:
codex -m gpt-6.1-sol -c model_context_window=1000000 -c model_auto_compact_token_limit=900000
配置文件的官方说明见 developers.openai.com/codex/config-basic,三行配置的具体写法来自社区实测(腾讯云开发者社区、知乎专栏等,均有截图验证)。
解法三:拆小任务,减少单次输入
- 一次只给一个明确的子任务,关键需求写进提示,别指望从聊天记录里翻
- 需要检索整库时用子 Agent 查完,把摘要交回主对话,避免整段查找过程塞进主上下文
- 主动在合适的节点压缩,不要每次都等到触发线
目的:同样的窗口下少装内容,压缩自然更少发生。和站内 ChatGPT Work 与 Claude Code 的对比 里说的工程习惯是一致的。
额度注意:免附加费不等于更省额度
- 订阅侧免的是长上下文附加费,任务照常消耗订阅额度
- 缓存能复用已处理内容,读取成本更低,但每次读取仍计入用量,反复读取越多消耗累积越快。这正是 2026 年 7 月 OpenAI 把 272k 提到 372k 后又退回的原因:当时开发者 Theo 猜测是超 272k 按两倍收费,Tibo 澄清多扣的用量来自缓存反复读取(来源:新智元报道)
- API 调用仍按 API 价格表计费,GPT-6.1 Sol 标准定价为输入 2 美元、输出 10 美元、缓存输入 0.10 美元每百万 token(来源:OpenAI 发布相关报道)
对比一句:Claude Code 里的 Opus 5.5 和 Sonnet 5.5 默认上下文已是 1M,两边收费范围不同,OpenAI 免的是订阅额度附加费,Claude 是 API 单价不涨。窗口大小不是越开越好,默认 500k 是官方测试后认为更适合多数用户的设置,先感受默认值再考虑手动调。
常见问题
Codex 上下文压缩一次要等多久?
取决于会话里堆积的内容量,社区实测一次最长可达两分钟(开发者 Lasse 的吐槽)。10 月 12 日默认窗口扩到 500k 后,压缩触发频率已大幅下降。
默认 500k 升级后还需要手动调 1M 吗?
多数任务不需要。默认 500k 是官方测试后认为更适合多数用户的设置;只有长任务仍频繁压缩时才手动开 1M,按上面三行配置或临时 CLI 参数操作。
手动开到 1M 会多扣额度吗?
订阅侧不收长上下文附加费,但任务照常消耗订阅额度,且上下文变长后缓存反复读取次数更多,消耗可能累积得更快。API 调用则按 API 价格表计费。
为什么默认 500k 后额度还是掉得快?
免附加费不等于更省额度。你只敲一句「继续」,Agent 仍要带上前面读过的文件、测试结果和要求,缓存读取每次计入用量,读的次数一多消耗就上来了。这也是 7 月 OpenAI 从 372k 退回 272k 的原因。
Codex 和 Claude Code 的上下文差多少?
Claude Code 里 Opus 5.5 和 Sonnet 5.5 默认已是 1M,是 Codex 新默认值 500k 的两倍;但 Codex 上限同样能到 1M,只是默认给 500k。收费范围两边不同:OpenAI 免的是订阅附加费,Claude 是 API 单价不涨。
压缩后漏掉了最初的需求怎么办?
把核心需求重新写进下一条消息,明确说「保持 X 不变、Y 继续实现」;更稳的做法是把不可妥协的需求写进提示或任务文件,别只依赖早期对话。
 京ICP备2024094994号-29